Dapatkan penawaran menarik sekarang
Jawaban Singkat
Crawling adalah proses perayapan ketika bot mesin pencari seperti Googlebot menemukan dan membaca halaman web dengan mengikuti tautan dan sitemap.
- Crawling berbeda dari indexing: crawling menemukan dan membaca halaman, sedangkan indexing menyimpan isinya ke indeks, sehingga halaman yang dirayapi belum tentu diindeks.
- Crawling berbeda dari web scraping: crawling menelusuri halaman untuk mengidentifikasi URL di mesin pencari, sedangkan scraping mengekstrak data tertentu dari situs ke format seperti CSV.
Ditinjau oleh Muhammad Robith Adani Didukung 3 sumber
Daftar Isi
Crawling artinya perayapan, yaitu proses ketika crawler (bot mesin pencari seperti Googlebot) menemukan dan membaca halaman web dengan mengikuti tautan dan sitemap. Halaman yang berhasil dirayapi kemudian diproses pada tahap indexing agar dapat muncul di hasil pencarian Google maupun mesin pencari lain.
Maka dari itu, selain memperhatikan kaidah SEO (Search Engine Optimization), Anda juga harus tahu proses crawling ini.
Mungkin Anda bertanya-tanya, apa itu crawling? Bagaimana cara kerjanya? Apa saja fungsi dan contohnya? Dan apa perbedaannya dengan web scraping?
Untuk mendapatkan jawaban dari semua pertanyaan tersebut, Anda bisa menyimak penjelasannya di artikel ini.
Apa itu Crawling?
Secara bahasa, crawling artinya ‘merayap’. Bila diartikan secara teknis, crawling adalah proses penelusuran website atau situs dengan tools yang bernama crawler.
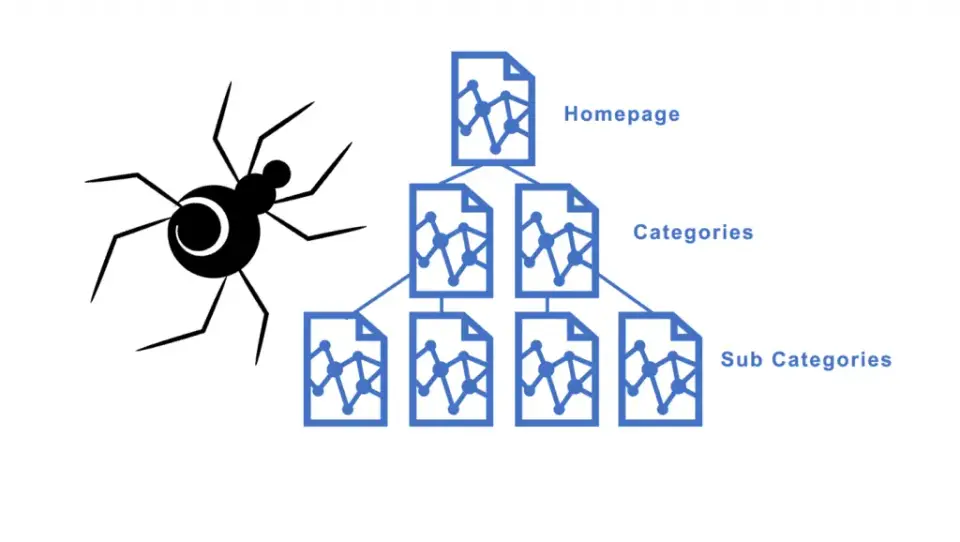
Konsep crawler yang merayapi website © Animas Marketing
Tujuan crawling adalah untuk mengidentifikasi suatu laman website agar mesin pencari dapat mengelompokkannya ke kategori tertentu dengan mudah.
Apabila masih bingung dengan istilah ini, bayangkan saja Anda masuk ke dalam sebuah minimarket atau swalayan.
Tentunya, barang-barang di dalam swalayan tersebut telah dikelompokkan sesuai dengan tipe atau jenisnya, sehingga pengunjung dapat menemukan barang yang mereka cari dengan mudah.
Sebelum mengelompokkan suatu barang, pastinya pekerja di toko tersebut telah memeriksa dan memilah-milah setiap barang sesuai jenis atau tipenya.
Nah, hal tersebut juga berlaku dalam konsep crawling. Akan tetapi, proses perayapan pada sebuah situs menggunakan robot atau tools yang disebut dengan crawler atau perayap.
Arti Crawl di Luar Dunia SEO
Dalam bahasa Indonesia, crawling artinya merayap atau merangkak. Karena itu, kata ini juga dipakai di bidang lain dengan makna berbeda.
Di dunia penyiaran, crawl berita adalah teks berjalan di bagian bawah layar televisi yang memuat ringkasan berita singkat, sering disebut juga news ticker atau running text. Crawl tersusun dari kalimat-kalimat pendek berisi inti informasi, sehingga penonton tetap mendapat kabar terbaru tanpa mengganggu tayangan utama.
Sementara itu, di dunia renang, front crawl adalah nama lain gaya bebas. Jadi, bila Anda membaca istilah crawling di artikel tentang website dan mesin pencari, maknanya adalah proses perayapan halaman web oleh bot.
Perbedaan Crawling dan Indexing
Crawling adalah tahap menemukan dan membaca halaman, sedangkan indexing adalah tahap menyimpan dan menganalisis isi halaman tersebut ke dalam basis data (indeks) mesin pencari.
Urutannya selalu crawling lebih dulu, baru indexing. Namun, halaman yang sudah dirayapi belum tentu diindeks. Mesin pencari bisa memutuskan tidak mengindeks halaman yang isinya duplikat, kualitasnya rendah, atau memakai tag noindex. Hanya halaman yang sudah masuk indeks yang bisa muncul di hasil pencarian. Gambaran lengkap alurnya, dari crawling hingga peringkat, dapat Anda baca di cara kerja algoritma Google.
Perbedaan Crawling dan Web Scraping
Mungkin Anda penasaran terkait perbedaan antara crawling dengan web scraping. Pada bagian ini, kami akan menjelaskan perbedaan antara kedua istilah tersebut. Berikut penjelasannya.
1. Definisi
Crawling adalah proses penelusuran situs sebelum melakukan pengindeksan ke database mesin pencari, sedangkan web scraping adalah proses ekstraksi data situs ke format file yang baru, seperti csv.
2. Fokus dan Cakupan
Proses perayapan memiliki fokus dan cakupan yang lebih besar karena melingkupi seluruh laman pada suatu situs.
Di sisi lain, aktivitas web scraping hanya berfokus pada sekumpulan dari data spesifik situs tertentu.
3. Tujuan
Tujuan proses crawling adalah untuk menelusuri dan mengidentifikasi URL sebuah situs di mesin pencari.
Sementara itu, web scraping memiliki tujuan untuk menghasilkan data situs agar bisa dilakukan analisis lebih lanjut.
4. Output
Pada proses perayapan, output yang dapat Anda peroleh adalah daftar URL situs. Sementara itu, web scraping akan memberikan output berupa data, seperti nama produk, daftar harga, dan lain sebagainya.
Fungsi Crawling
Setelah mengetahui pengertiannya, kini saatnya Anda mengetahui fungsi crawling, yaitu:
1. Mengumpulkan Informasi
Crawling memungkinkan mesin pencari untuk mengumpulkan data dari halaman-halaman web di seluruh internet.
Ini termasuk teks, gambar, tautan, dan elemen-elemen lainnya yang ditemukan di situs web.
2. Memperbarui Data
Fungsi selanjutnya adalah membantu mesin pencari untuk memperbarui informasi yang telah dikumpulkan sebelumnya.
Dengan terus menjelajahi web secara teratur, mesin pencari dapat memastikan bahwa data yang disajikan kepada pengguna tetap relevan dan up-to-date.
3. Menemukan Tautan Baru
Adanya perayapan ini memungkinkan mesin pencari menemukan tautan baru yang muncul di internet.
Hal ini membantu dalam memperluas indeks mesin pencari dan memungkinkan pengguna menemukan konten baru.
4. Mengidentifikasi Perubahan pada Halaman Web
Jika ada perubahan pada halaman web yang telah diindeks sebelumnya, crawling membantu mesin pencari mengidentifikasi perubahan tersebut.
Ini dapat mencakup perubahan konten, struktur situs, atau tautan.
5. Mengoptimalkan Proses Pencarian
Fungsi yang terakhir adalah membantu mesin pencari mengoptimalkan proses pencarian dengan memprioritaskan halaman-halaman web yang dianggap lebih penting atau relevan. Pada situs berukuran besar, jatah perayapan ini dikenal sebagai crawl budget.
Jenis-Jenis Crawler
Dalam praktiknya, ada banyak crawler yang digunakan untuk melakukan perayapan. Adapun di antaranya, yaitu:
- News crawling. Jenis satu ini melakukan perayapan untuk mengidentifikasi konten-konten berita
- Social Media Crawling. Sesuai namanya, jenis ini melakukan perayapan untuk media sosial. Namun, tidak semua media sosial mengizinkan crawler untuk merayapinya
- E-mail Crawling. Perayapan ini dilakukan untuk mengidentifikasi alamat e-mail pengguna. Namun, aktivitas ini harus ada izin agar tidak melanggar privasi
- Image Crawling. Kegiatan perayapan ini diterapkan pada gambar untuk menemukan gambar yang relevan dengan pengguna
- Video Crawling. Mirip dengan sebelumnya, aktivitas perayapan ini dilakukan untuk mengindeks video
Cara Kerja Crawler
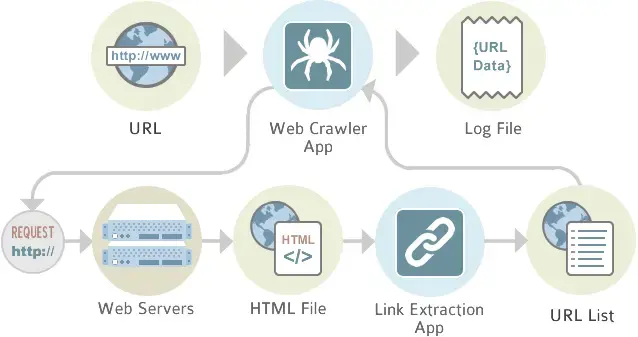
Cara kerja crawler. © ResearchGate/Magda Foti
Sebelumnya, telah dijelaskan bahwa, proses crawling dilakukan oleh sebuah tools bernama crawler website. Pertanyaannya, bagaimana cara kerja crawler ini?
Pertama-tama, crawler mesin pencari menemukan URL baru, terutama dengan mengikuti tautan dari halaman yang sudah dikenal dan membaca sitemap yang dikirimkan pemilik situs.
Sitemap membantu crawler mengetahui halaman mana saja yang ada di situs Anda, sehingga halaman baru lebih mudah ditemukan.
Setelah itu, crawler mengunduh dan membaca isi halaman tersebut, termasuk teks, gambar, dan tautan di dalamnya. Tautan baru yang ditemukan akan dimasukkan ke antrean untuk dirayapi berikutnya.
Hasil perayapan kemudian diproses pada tahap indexing, yaitu ketika mesin pencari menganalisis dan menyimpan isi halaman ke dalam indeksnya.
Halaman yang sudah masuk indeks barulah dapat ditampilkan di Search Engine Result Pages (SERP).
Namun, perlu dicatat bahwa crawler mungkin saja tidak menemukan situs baru Anda dalam waktu singkat.
Saat hal ini terjadi, Anda bisa meminta crawler untuk merayapi situs web dengan cara memasukkan URL (Uniform Resource Locator) website ke Google Search Console.
Perlu diingat, crawler hanya akan melakukan penelusuran kepada situs web yang bersifat publik, bukan private.
Crawler tidak akan pernah melakukan kunjungan pada situs yang tidak dapat ia akses. Hal tersebut terjadi karena crawler melakukan perayapan sesuai dengan perintah robots.txt.
Robots.txt adalah file milik situs tertentu yang memuat informasi terkait laman yang boleh dan yang tidak boleh diakses.
Contoh Crawler
Diketahui, untuk menjalankan proses perayapan, setiap mesin pencari menggunakan crawler yang berbeda-beda.
Berikut ini adalah jenis crawler dari berbagai macam mesin pencari:
- Googlebot. Robot crawler milik Google. Googlebot bekerja dengan cara mengumpulkan data dan mengindeksnya di mesin pencari Google
- Slurp Bot. Crawler milik Yahoo. Saat ini hasil pencarian web Yahoo sebagian besar ditenagai oleh Bing, sehingga peran Slurp tidak lagi sebesar dulu
- BingBot. Sesuai dengan namanya, crawler ini milik mesin pencari Bing yang bisa mengindeks halaman-halaman di mesin pencari Bing
- DuckDuckBot. Bot ini merupakan web spider milik DuckDuckGo. Web spider ini mampu memberikan hasil yang sesuai tanpa melacak riwayat user
- AlexaBot. Crawler ini dulu milik layanan Alexa Internet dari Amazon dan digunakan untuk mengidentifikasi konten pada situs tertentu. Layanan Alexa.com sudah dihentikan Amazon pada 1 Mei 2022
- Baiduspider. Crawler ini milik mesin pencari Baidu, asal China. Robot ini sama seperti crawler yang lainnya, yaitu menelusuri dan mengindeks situs
- Yandex Bot. Robot crawler milik mesin pencari asal Rusia yang bernama Yandex
Demikianlah artikel terkait crawling. Pada intinya, crawling adalah proses perayapan situs web menggunakan crawler suatu mesin pencari.
Proses ini bertujuan untuk mengidentifikasi suatu situs sebelum melakukan indeks di mesin pencari.
Jadi, agar situs web bisa diindeks dan ditampilkan di SERP, Anda harus memperhatikan proses crawling ini.
Sitespirit menyediakan jasa SEO profesional untuk membantu optimalkan bisnis Anda di mesin pencari secara organik.
Pertanyaan yang Sering Diajukan
Apa arti crawl pada berita televisi?
Crawl berita adalah teks berjalan di bagian bawah layar televisi yang memuat ringkasan berita singkat, sering disebut news ticker atau running text. Maknanya berbeda dari crawling pada website.
Bagaimana crawler menemukan halaman baru di sebuah website?
Crawler menemukan URL baru terutama dengan mengikuti tautan dari halaman yang sudah dikenal dan membaca sitemap. Tautan baru yang ditemukan masuk antrean untuk dirayapi berikutnya.
Mengapa halaman yang sudah dirayapi belum tentu muncul di hasil pencarian?
Karena crawling hanya menemukan dan membaca halaman. Mesin pencari bisa memutuskan tidak mengindeks halaman yang isinya duplikat, kualitasnya rendah, atau memakai tag noindex.
Apa saja contoh crawler dari mesin pencari?
Contohnya Googlebot milik Google, BingBot milik Bing, DuckDuckBot milik DuckDuckGo, Baiduspider milik Baidu, dan Yandex Bot milik Yandex.
Referensi
- Google (2025). In-depth guide to how Google Search works
- Google (2026). What Is Googlebot
- Google (2025). Introduction to robots.txt
Layanan Sitespirit yang Berkaitan
- Jasa SEO Tim Sitespirit menyusun strategi SEO teknis, konten, dan pelaporan sesuai target bisnis Anda. Lihat layanan →
- Jasa Pembuatan Website Dari perencanaan, desain, hingga peluncuran, website Anda dikerjakan tim Sitespirit yang berbasis di Malang. Lihat layanan →
- Jasa Desain Website Desain UI/UX yang berangkat dari kebutuhan pengguna dan tujuan bisnis Anda. Lihat layanan →
Punya pertanyaan tentang topik ini? Chat WhatsApp atau isi formulir konsultasi.

Ditulis oleh
Rifqi likes to read scientific papers and make an analysis of the documents.
LinkedIn →Ditinjau oleh Muhammad Robith Adani, SEO & Content Specialist pada